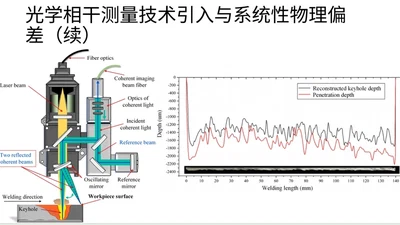
基于 LSTM 网络的不锈钢薄板激光搭接焊熔深光学相干监测研究
面向不锈钢薄板激光搭接焊的 OCT 熔深监测框架,结合 EMD 自适应重构与 LSTM 时序补偿,攻克 6.8ms 物理迟滞与多次反射测量偏差难题。
陈柏彤
面向不锈钢薄板激光搭接焊的 OCT 熔深监测框架,结合 EMD 自适应重构与 LSTM 时序补偿,攻克 6.8ms 物理迟滞与多次反射测量偏差难题。
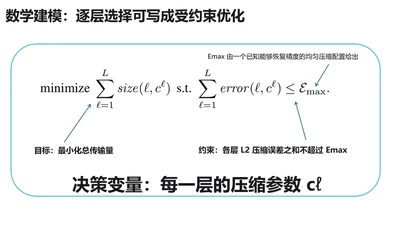
将逐层压缩参数选择建模为受约束优化问题并通过动态规划求解,在同等精度下实现最高 5.2 倍的梯度压缩率,显著缓解分布式训练的通信瓶颈。

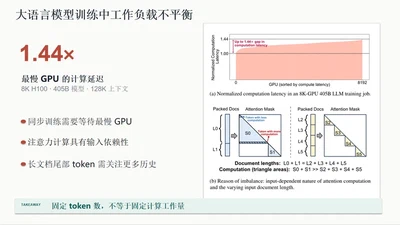
面向长上下文 LLM 训练的负载均衡型 4D 并行方法,通过在 PP 层做变长打包与 outlier delay、在 CP 层做 Per-Doc 分片与自适应选择,把调度单位从 token 数转向真实 workload,实现平均 1.23× 端到端加速且不改变收敛趋势。

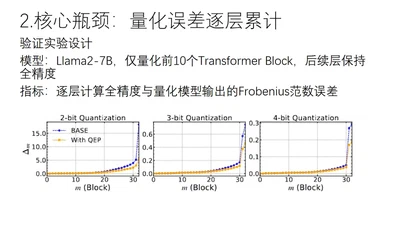
重新审视逐层 PTQ 的框架,显式建模跨层量化误差传播,利用上游累积的激活量化误差对当前层权重做补偿矫正,并通过可控缩放因子抑制过拟合,在 Llama 与 Mistral 系列上 INT2/INT3/INT4 精度均优于 RTN、GPTQ、AWQ 与 QuIP。

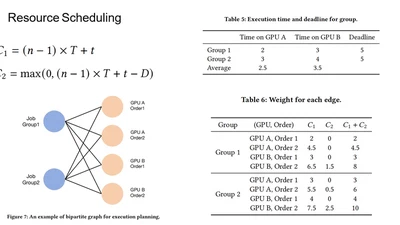
面向异构 GPU 集群的截止时间感知作业打包系统,通过构建考虑运行时干扰的估计模型并求解优化问题来共置深度学习训练作业,相比 Muri 显著提升截止时间满足率并降低归一化 JCT。

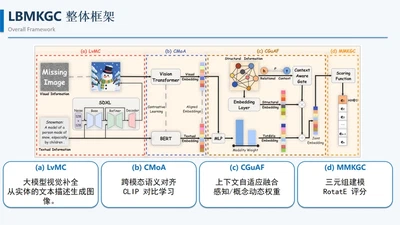
面向多模态知识图谱补全的均衡融合框架,结合 SDXL 视觉补全、CLIP 跨模态语义对齐与上下文自适应融合,缓解跨实体模态不均衡与模态贡献不一致问题。

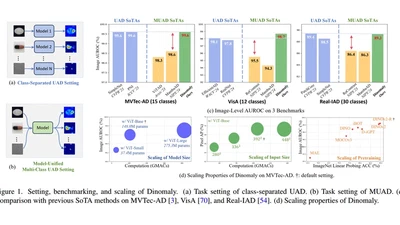
面向多类别无监督异常检测的极简纯 Transformer 框架,通过 Dropout 噪声瓶颈、线性注意力与宽松重建约束,破解恒等映射难题。
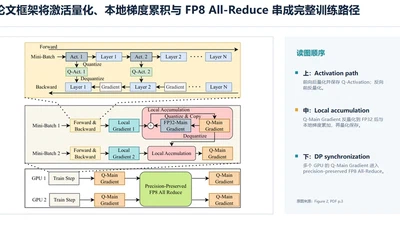
面向 LLM 训练的系统级低比特框架,联合压缩激活存储、梯度存储与梯度通信,只对误差最敏感的操作保持高精度,显著降低训练显存与 DP 通信开销。
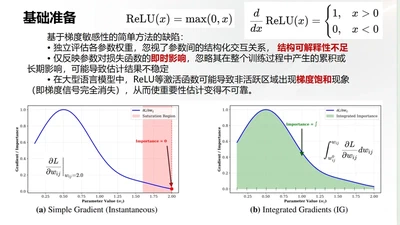
面向 LoRA 的自适应秩分配方法,用梯度积分(IG)替代瞬时梯度来评估参数重要性以缓解梯度饱和,并通过结合偏差追踪的指数移动平均构建不确定性感知评分,在 GLUE、BoolQ、GSM8K 等任务上优于 LoRA、AdaLoRA、DoRA 等基线。
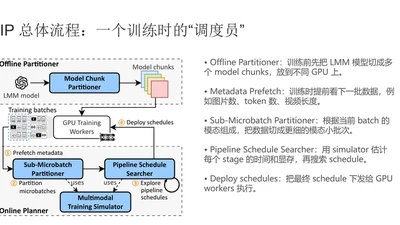
面向 LMM 训练的动态交错流水线系统,通过模态分离切分消除段内不均衡、按模态拆分子微批次缓解段间不均衡,并用基于 MCTS 的调度搜索器与代价模拟器在线寻找近似最优流水线调度,在 GPU 训练的同时完成搜索而不拖慢训练。
